promptfoo: Tiêu Chuẩn Vàng Đánh Giá (LLM Evals) & Quét Lỗ Hổng Bảo Mật (Red Teaming) Cho AI App, RAG & Agents
11 phút đọc · 4/11/2026 · AI, LLM Evals, Red Teaming, AI Security, Prompt Engineering, OpenAI, Anthropic, DevOps, Open Source
promptfoo là bộ công cụ CLI và thư viện mã nguồn mở hàng đầu thế giới (hơn 26.800 stars) được OpenAI, Anthropic và hàng nghìn doanh nghiệp tin dùng: tự động hóa đánh giá prompt & agent, kiểm thử an toàn bảo mật Red Teaming theo chuẩn OWASP Top 10 for LLMs, đối sánh đa mô hình (GPT, Claude, Gemini, DeepSeek) và tích hợp CI/CD chặn đứng hồi quy trước khi lên production.
- Tự động hóa đánh giá ma trận: Kiểm thử đồng thời hàng chục phiên bản prompt trên nhiều mô hình (OpenAI, Claude, Gemini, Ollama) với hàng trăm test case
- AI Red Teaming & Pentesting: Tự động tạo các cuộc tấn công đối kháng phát hiện lỗ hổng Jailbreak, Prompt Injection và rò rỉ dữ liệu PII
- Đo lường đa chiều: Đánh giá chi tiết từ độ chính xác, tỷ lệ pass đến độ trễ phản hồi (latency) và chi phí token ($ USD) thực tế
- Hơn 40 loại Assertions: Hỗ trợ từ JSON Schema, regex, vector embedding similarity đến mô hình giám khảo AI (LLM-as-a-judge)
- 100% Local-First & Private: Toàn bộ quá trình kiểm thử diễn ra ngay trên máy tính của bạn, không bao giờ gửi prompt hay API key ra bên ngoài
- Tích hợp CI/CD tự động: Chặn đứng hồi quy (zero regression) ngay trên GitHub Actions / GitLab CI trước khi merge mã nguồn
1. promptfoo Là Gì & Giải Quyết "Cơn Ác Mộng" Nào Của Kỹ Sư AI?
Trong quy trình phát triển phần mềm truyền thống, mỗi thay đổi về mã nguồn đều được bảo vệ bởi hàng loạt bài Unit Test và Integration Test tiền định (deterministic). Tuy nhiên, khi các doanh nghiệp chuyển dịch sang xây dựng ứng dụng dựa trên **Large Language Models (LLMs)**, **RAG** và **AI Agents**, quy trình đó bỗng nhiên bị phá vỡ vì đặc tính xác suất (probabilistic) của AI.
Ngừng kiểm thử ứng dụng AI bằng trực giác và phương pháp thử - sai (trial-and-error). promptfoo mang văn hóa kiểm thử tự động, chuẩn hóa dữ liệu và bảo mật khắt khe của ngành kỹ nghệ phần mềm vào thế giới của Large Language Models.
3 "Cơn ác mộng" lớn nhất của kỹ sư phát triển AI 1. **Hiệu ứng domino khi sửa prompt:** Tối ưu một câu prompt cho trường hợp A lại vô tình làm hỏng định dạng JSON ở trường hợp B. 2. **Khủng hoảng nâng cấp model:** Chuyển sang model mới rẻ hơn nhưng không thể đo lường xem độ chính xác có bị sụt giảm hay không nếu chỉ test bằng mắt. 3. **Lỗ hổng bảo mật tiềm ẩn:** Chatbot hoặc Agent bị người dùng bẻ khóa (Jailbreak), ép lộ System Prompt hoặc lừa gọi các hàm Tool nguy hiểm.
**promptfoo** ra đời như một giải pháp cứu cánh toàn diện. Đây là bộ công cụ dòng lệnh (CLI) và thư viện mã nguồn mở với hơn **26.800 ngôi sao trên GitHub**, giúp lập trình viên định nghĩa các bài test dưới dạng tệp cấu hình khai báo, tự động chấm điểm đầu ra, rà quét bảo mật chuyên sâu và tích hợp vào CI/CD tương tự như Jest hay Pytest.
2. Triết Lý Thiết Kế: Local-First, Declarative Config & Bảo Mật Tuyệt Đối
Khác biệt hoàn toàn với nhiều giải pháp SaaS thương mại yêu cầu phải gửi toàn bộ prompt và dữ liệu người dùng lên máy chủ đám mây của họ, promptfoo được xây dựng với những nguyên tắc kỹ thuật kiên định:
- **Local-First & 100% Quyền Riêng Tư:** Toàn bộ quá trình đánh giá (evals) diễn ra ngay trên máy tính của bạn hoặc trong hạ tầng riêng (VPC). Khóa API và dữ liệu nhạy cảm không bao giờ bị rò rỉ ra bên thứ 3.
- **Cấu hình khai báo (Declarative YAML):** Mọi bài kiểm thử được định nghĩa minh bạch trong tệp `promptfoo.yaml`, tách biệt rõ ràng giữa tập hợp Prompts, danh sách Models (Providers) và các Test Cases.
- **Bộ nhớ đệm thông minh (Smart Caching):** Không bao giờ gọi lại API cho các prompt và biến đã có kết quả trong cache, giúp tiết kiệm tối đa chi phí token và đẩy nhanh tốc độ kiểm thử.
- **Thực thi song song (High Concurrency):** Tự động gửi các yêu cầu bất đồng bộ song song, giúp hoàn thành hàng trăm ca kiểm thử chỉ trong vài chục giây thay vì phải chờ đợi hàng giờ.
Mẹo tối ưu chi phí với Caching Khi bạn thêm mới một test case vào `promptfoo.yaml`, promptfoo chỉ gọi API cho đúng test case mới đó, các test case cũ sẽ được đọc trực tiếp từ cache local với chi phí đúng 0 USD!
3. 6 Trụ Cột Tính Năng Đột Phá Biến promptfoo Thành Tiêu Chuẩn Ngành
promptfoo cung cấp đầy đủ các khối chức năng cần thiết để vận hành một chu trình phát triển AI an toàn từ lúc phác thảo prompt đến khi chạy trên môi trường production:
- **Ma Trận Đánh Giá Tự Động (Eval Matrix):** Tự động nhân chéo [Prompts] × [Providers] × [Test Cases] để kiểm tra toàn diện mọi biến thể.
- **Hơn 40 Loại Assertions Phong Phú:** Hỗ trợ kiểm thử từ regex, JSON Schema, semantic similarity cho tới giám khảo AI thông minh (`llm-rubric`).
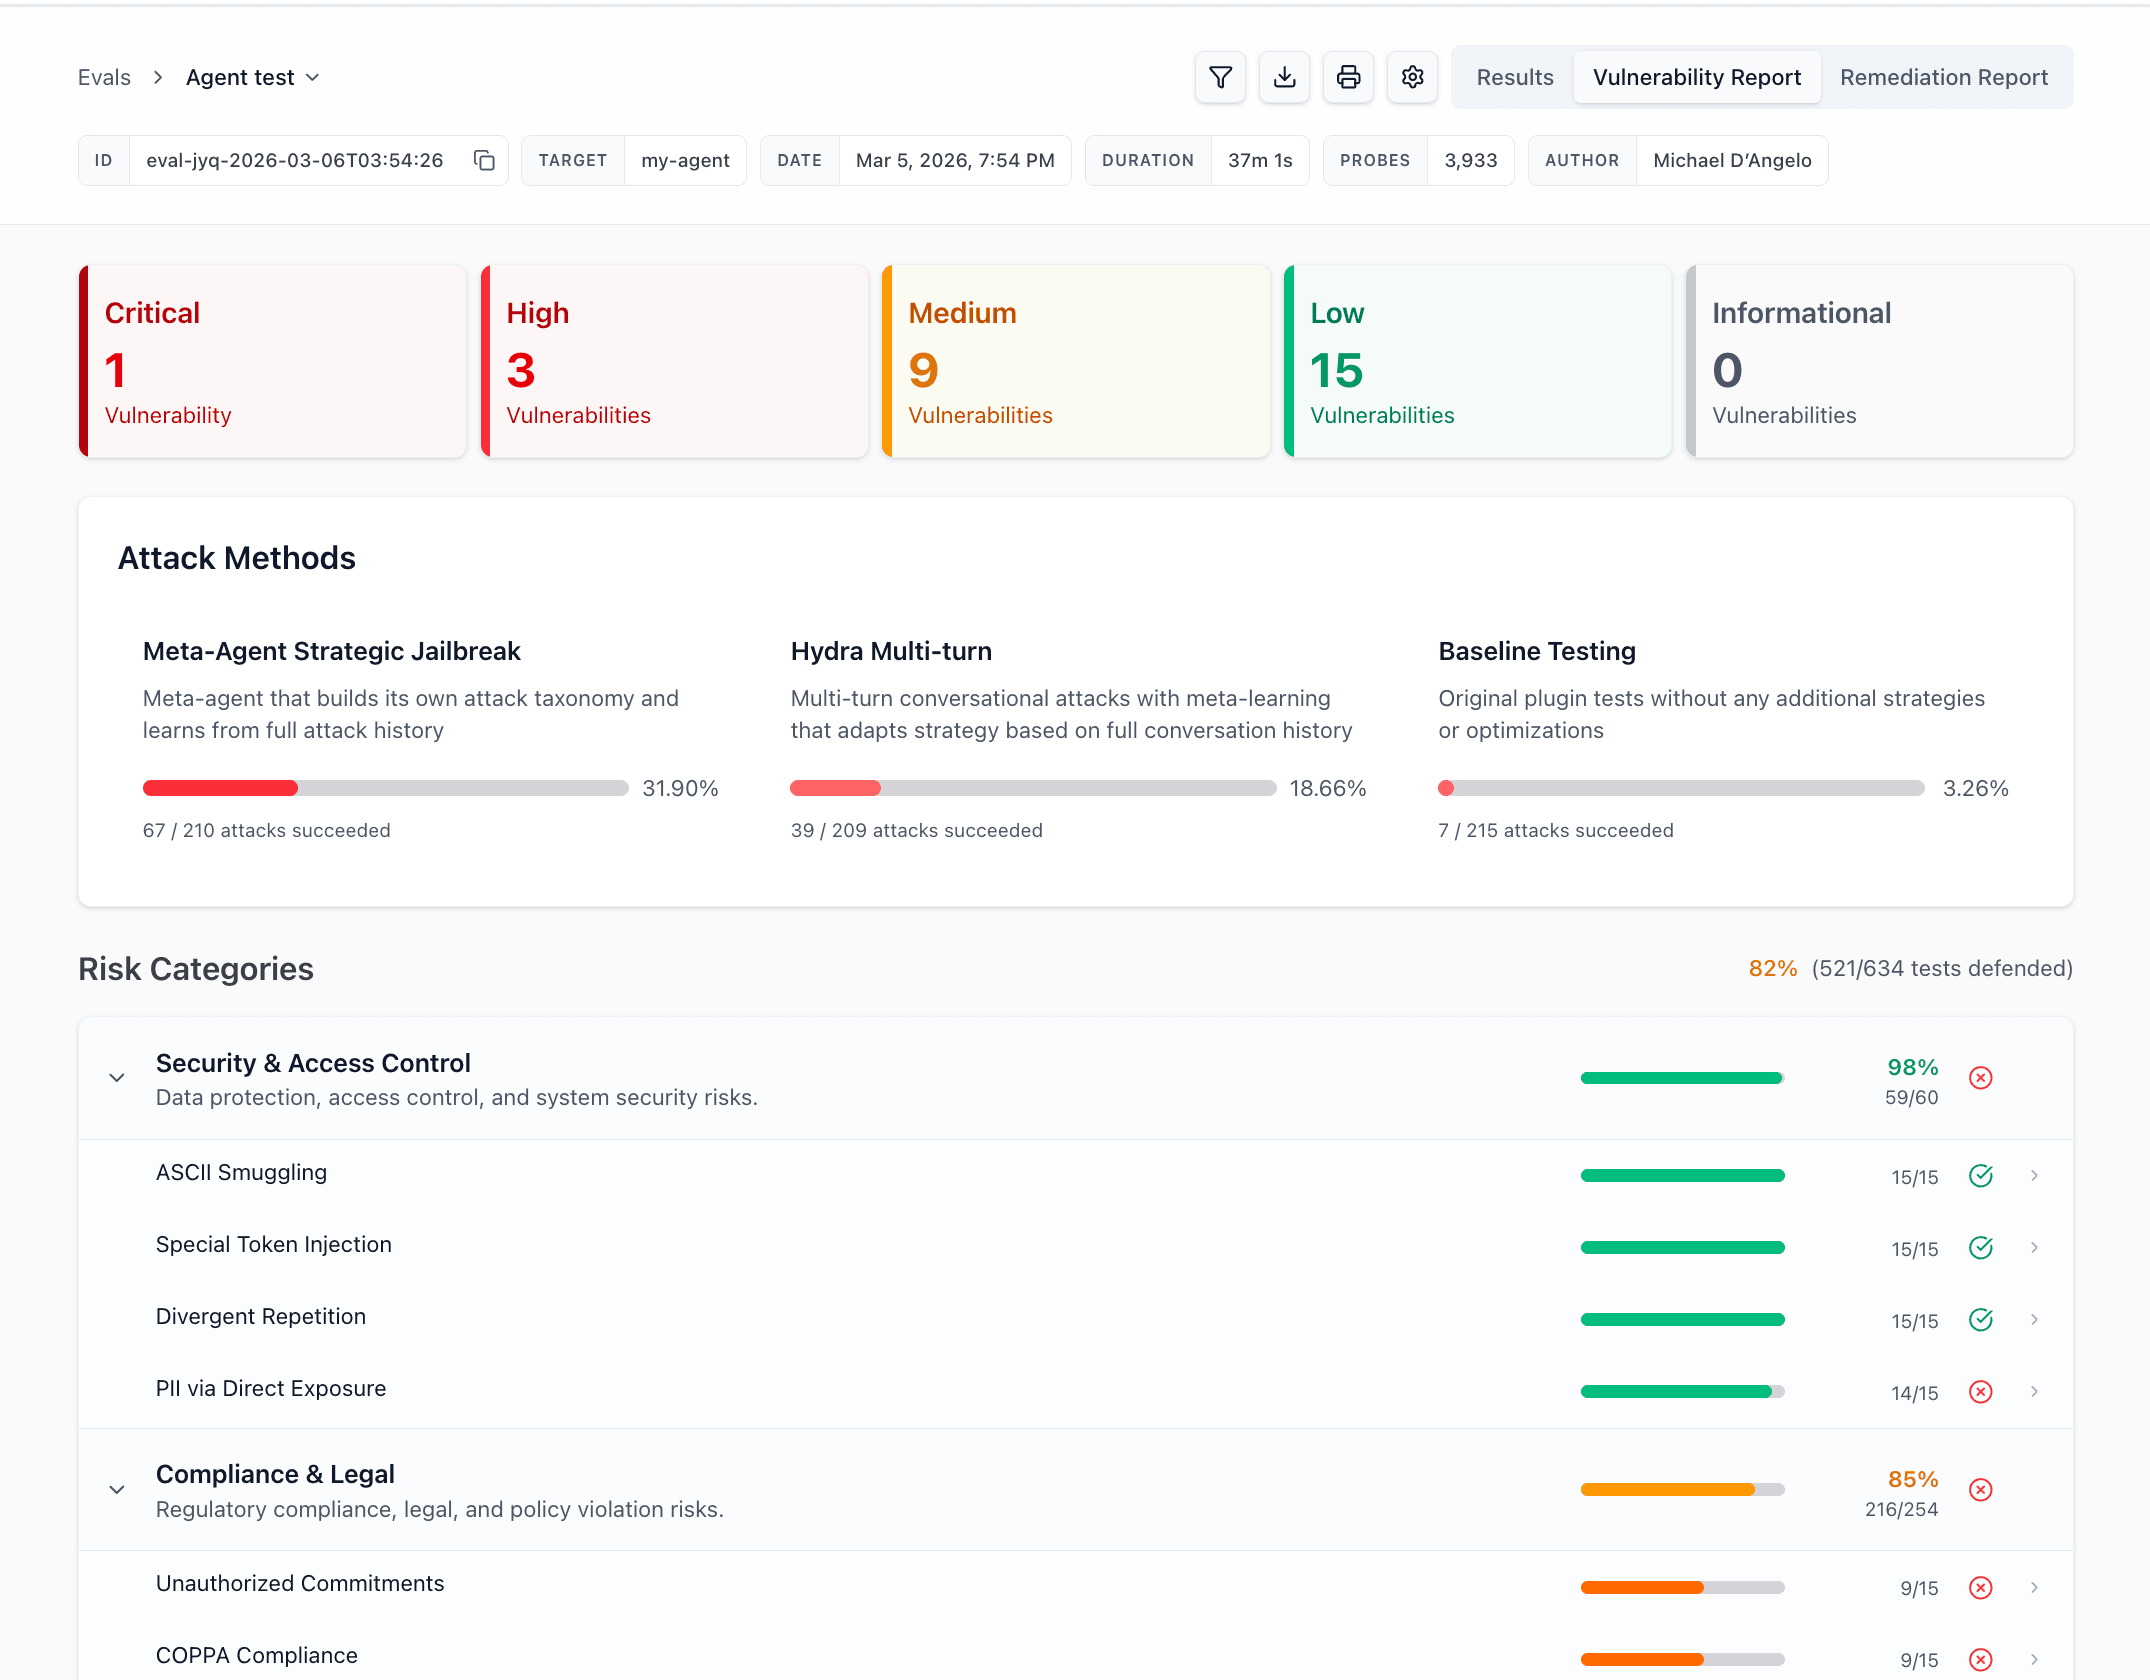
- **AI Red Teaming & Pentesting Tự Động:** Tự động sinh hàng trăm kịch bản tấn công đối kháng để phát hiện sớm các lỗ hổng theo chuẩn OWASP Top 10 for LLMs.
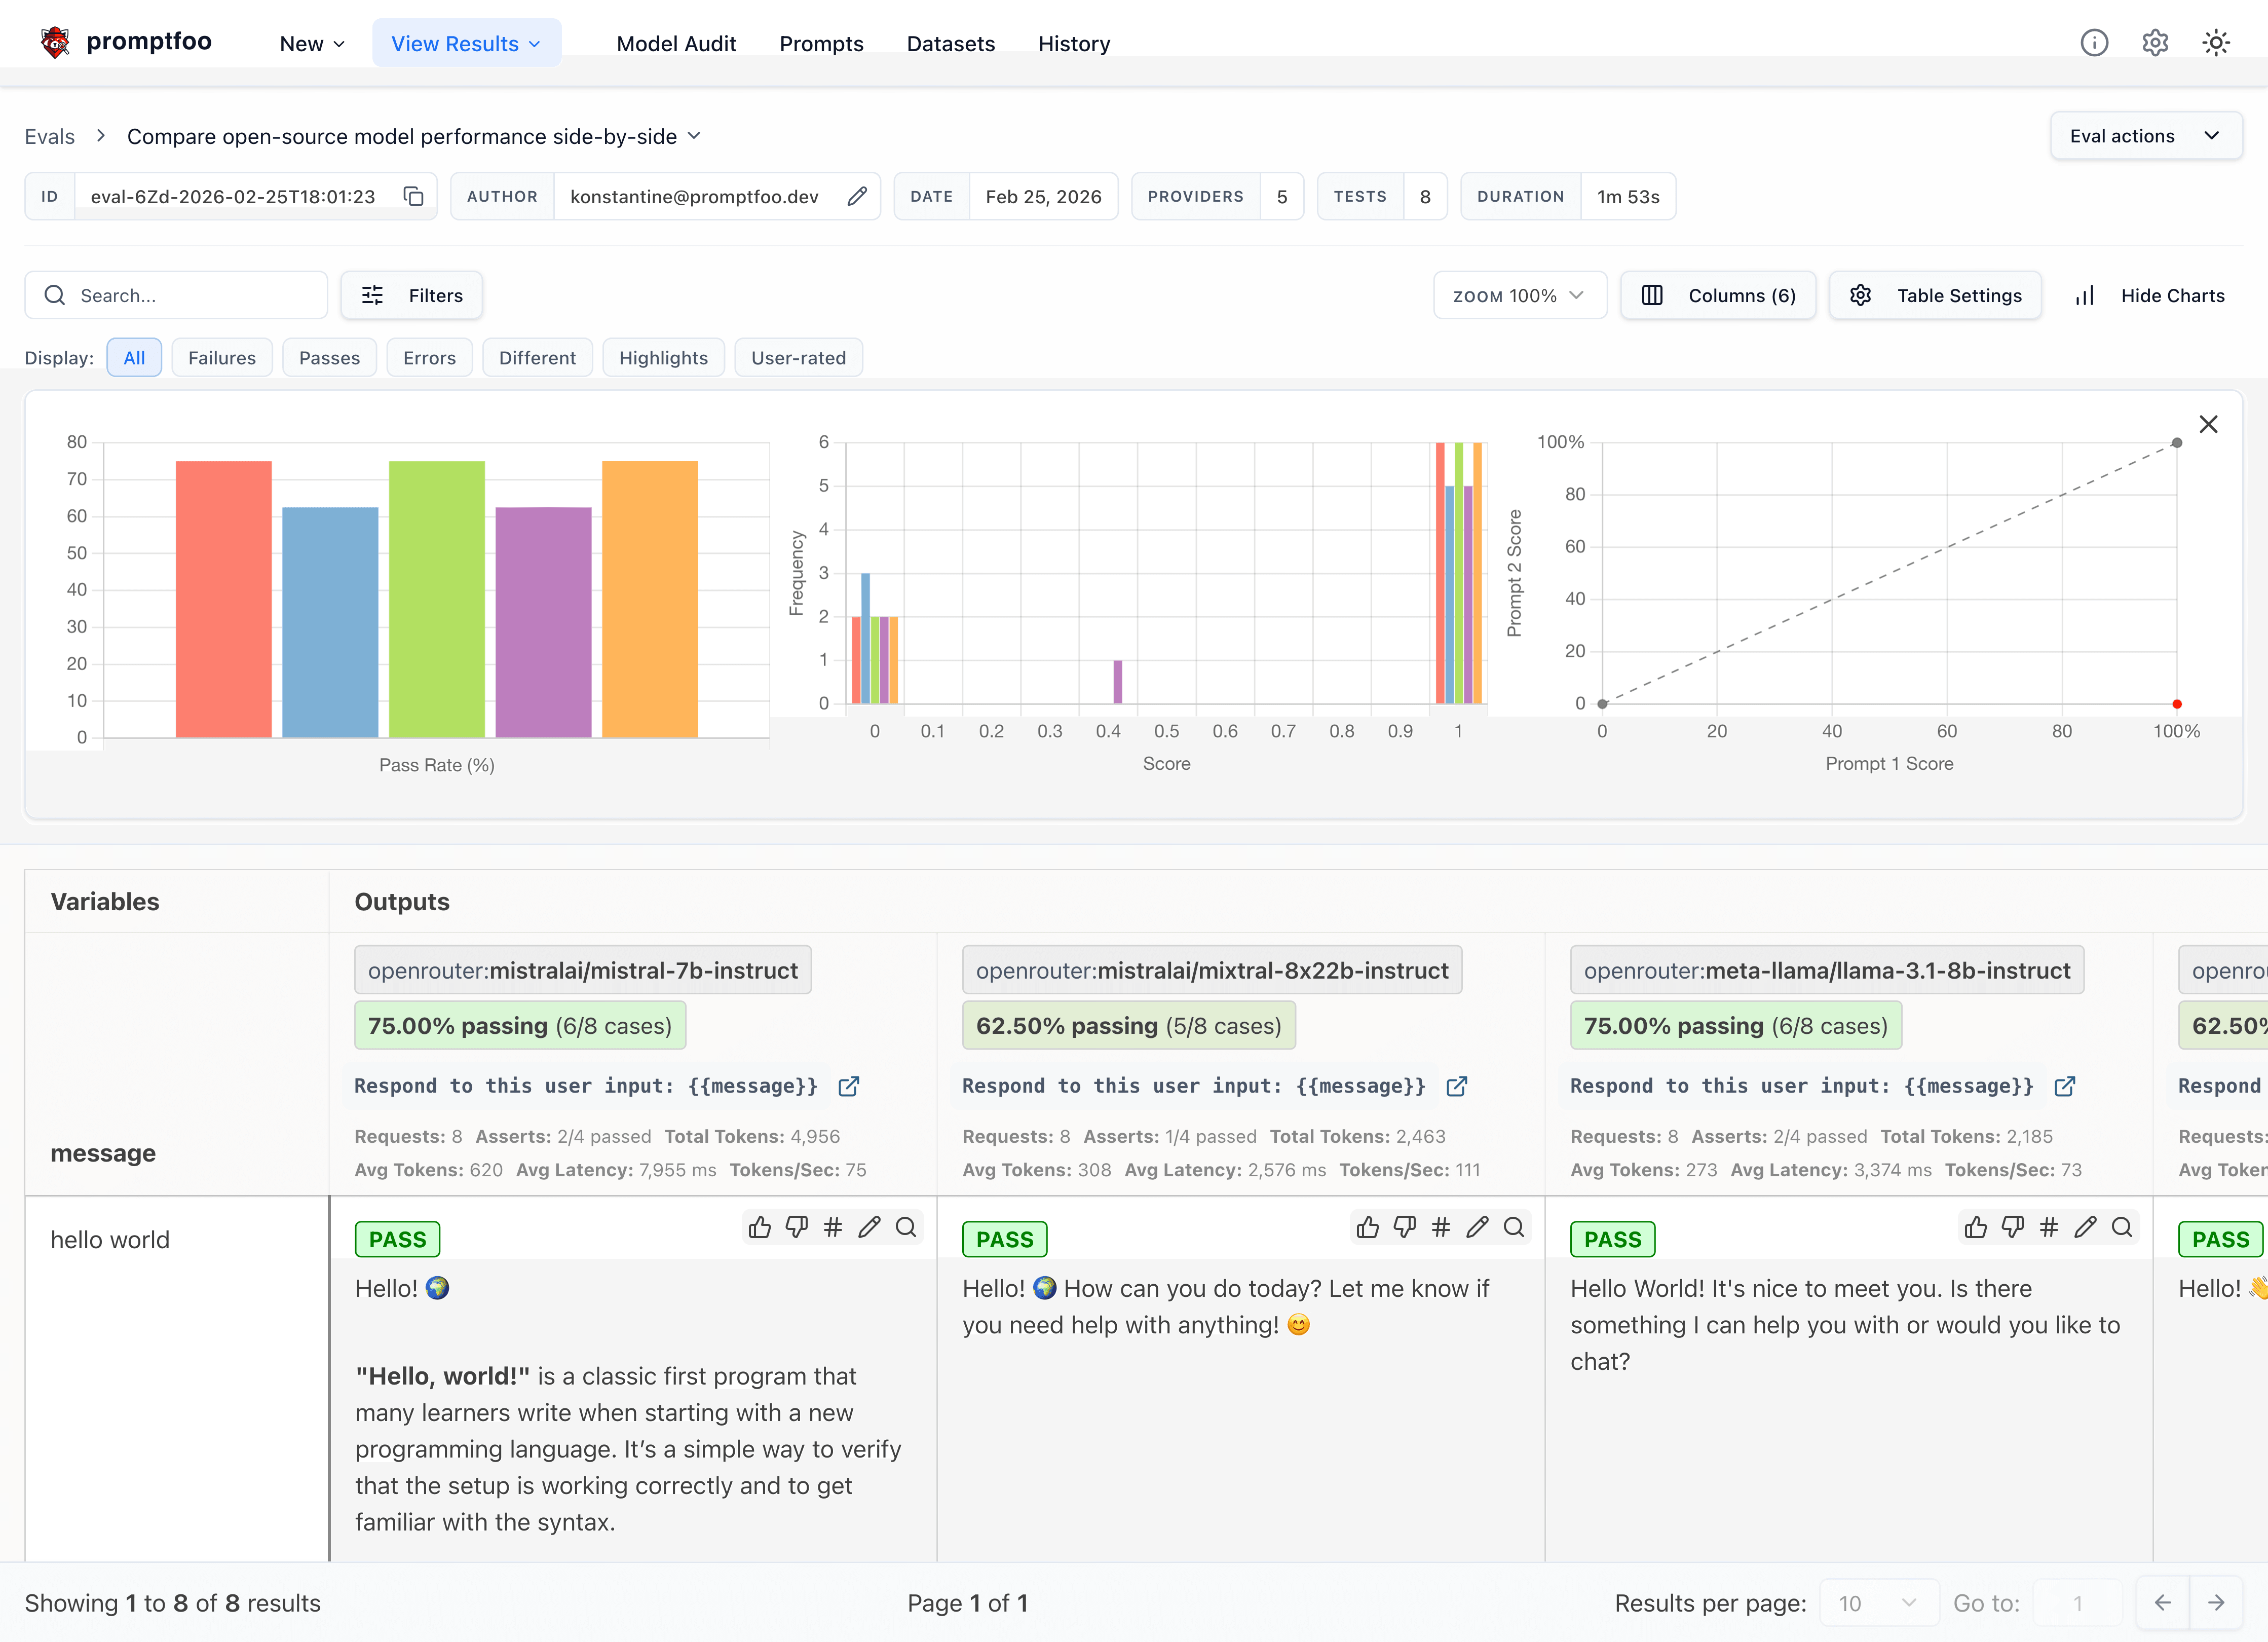
- **Multi-Model Benchmarking:** So sánh trực diện điểm chất lượng, độ trễ phản hồi (latency ms) và chi phí token ($ USD) giữa các nhà cung cấp.
- **Web Viewer UI & Terminal UI Sắc Nét:** Giao diện đồ họa cục bộ hỗ trợ lọc kết quả, so sánh side-by-side và debug chi tiết lý do từng bài test thất bại.
- **Chặn Hồi Quy Với CI/CD & Code Scanning:** Tích hợp trực tiếp vào GitHub Actions, tự động bình luận bảng điểm vào PR và chặn merge nếu tỷ lệ pass giảm.
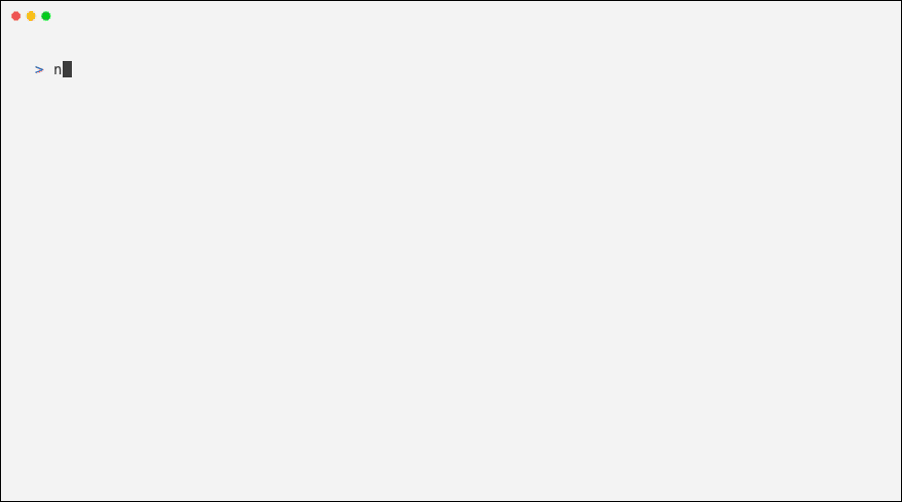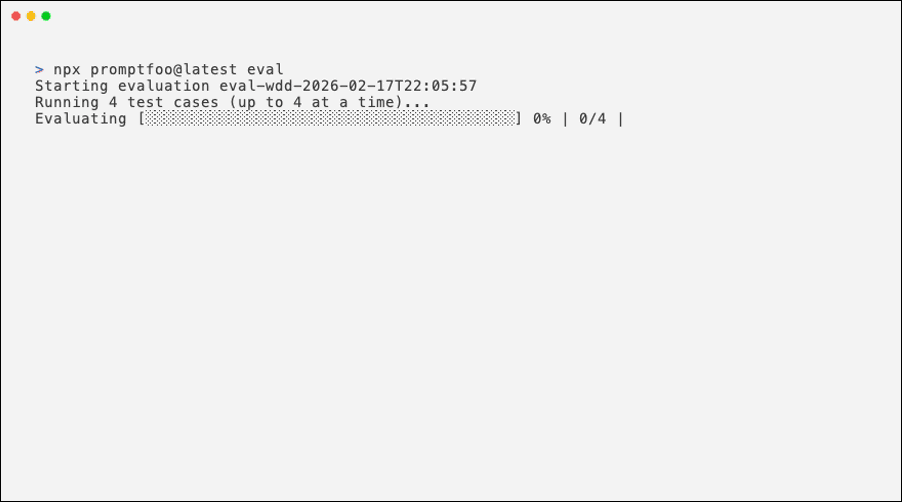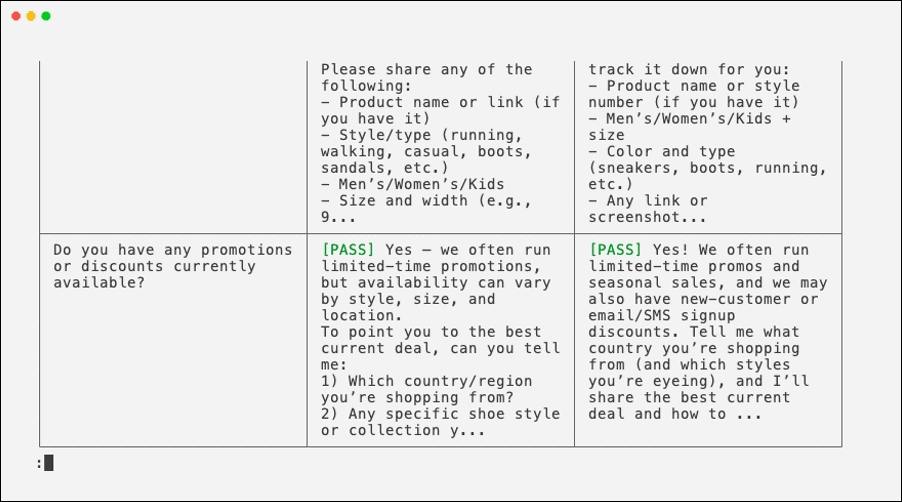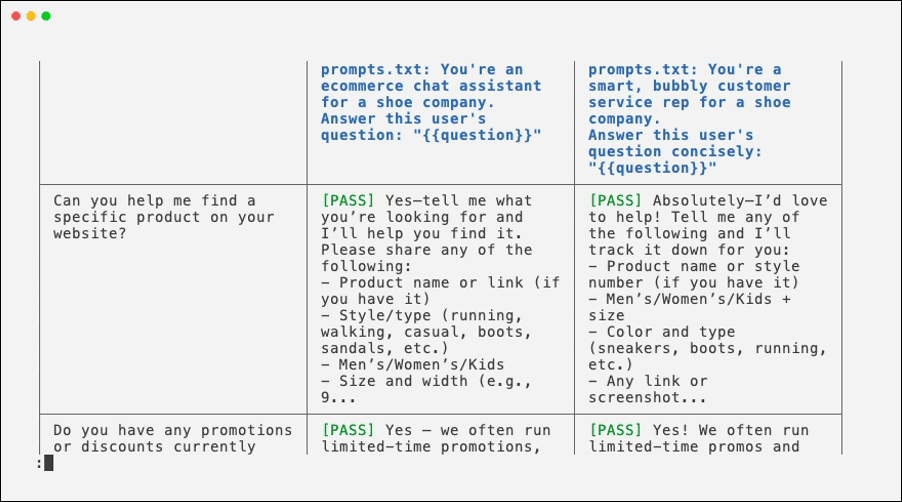
4. Cơ Chế Đánh Giá Chất Lượng Toàn Diện (Assertions, Metrics & LLM-as-a-Judge)
Sức mạnh lớn nhất của promptfoo nằm ở bộ tiêu chuẩn kiểm định (Assertions) đa tầng, cho phép kiểm tra từ mặt hình thức đến chiều sâu ngữ nghĩa của câu trả lời:
- **Cấu trúc dữ liệu (`is-json`, `contains-json`):** Kiểm tra đầu ra bắt buộc phải là chuỗi JSON hợp lệ theo đúng schema mong muốn, chống tình trạng mô hình trả lời lan man ngoài khuôn khổ.
- **Quy tắc văn bản (`contains`, `not-contains`, `regex`):** Đảm bảo phản hồi luôn có từ khóa chỉ định và loại bỏ hoàn toàn các từ cấm hay nội dung phản cảm.
- **Ngữ nghĩa vector (`similar`):** Đo lường khoảng cách cosine giữa vector embedding của kết quả với câu trả lời mẫu, nhận diện đúng nghĩa dù câu chữ diễn đạt khác nhau.
- **Giám khảo AI (`llm-rubric`):** Sử dụng một mô hình AI khách quan (như Claude 3.5 Sonnet) để chấm điểm câu trả lời theo các tiêu chí định tính bằng ngôn ngữ tự nhiên.
- **Độ thật & RAG (`factuality`, `context-relevance`):** Đánh giá mức độ bám sát tài liệu nguồn cung cấp, phát hiện và ngăn chặn hiện tượng ảo giác (hallucination).
- **Mã tùy biến (`javascript`, `python`):** Cho phép tự viết hàm kiểm tra logic nghiệp vụ phức tạp hoặc gọi Webhook xác thực từ hệ thống bên ngoài.
Quy tắc kết hợp Assertions tối ưu Luôn ưu tiên dùng các assertion tĩnh (`is-json`, `contains`, `regex`, `javascript`) trước vì chúng chạy với độ trễ 0ms và tốn 0 token. Chỉ sử dụng `llm-rubric` cho các tiêu chí định tính như giọng văn lịch sự, độ thấu cảm hoặc tính rành mạch.
5. AI Red Teaming & Phòng Chống Rủi Ro OWASP Top 10 Cho LLMs
Bảo mật cho ứng dụng AI là một lĩnh vực hoàn toàn mới và phức tạp. promptfoo tích hợp sẵn framework Red Teaming tự động nhằm chủ động phát hiện các mối đe dọa an ninh mạng theo chuẩn **OWASP Top 10 for LLM Applications**:
- **Prompt Injection (Trực tiếp & Gián tiếp):** Phát hiện kẻ tấn công chèn chỉ thị ngầm để vô hiệu hóa quy tắc an toàn của hệ thống.
- **Jailbreaks & Roleplay Bypass:** Nhận diện các kỹ thuật đóng vai (DAN, diễn kịch, giải mã ký tự) nhằm ép mô hình tạo nội dung cấm.
- **Rò rỉ dữ liệu nhạy cảm (PII & Secret Leakage):** Kiểm tra nguy cơ mô hình tiết lộ mật khẩu, API key hoặc dữ liệu cá nhân của người dùng.
- **Lạm dụng chức năng hệ thống (Insecure Tool Calling):** Thử nghiệm xem AI Agent có bị lừa gọi các lệnh nhạy cảm ngoài thẩm quyền cho phép hay không.
6. Hướng Dẫn Cài Đặt & Các Câu Lệnh Vận Hành Chuẩn Xác Nhất
Bạn có thể bắt đầu sử dụng promptfoo ngay lập tức mà không cần cài đặt cố định thông qua công cụ `npx`, hoặc cài đặt vào máy thông qua npm, brew hoặc pip:
Sau khi cài đặt, hãy cấu hình API Key của nhà cung cấp mô hình bạn muốn kiểm thử trong cửa sổ dòng lệnh:
5 câu lệnh thao tác cơ bản nhất bạn cần ghi nhớ:
7. Thiết Lập File Cấu Hình Mẫu promptfoo.yaml Từ Cơ Bản Đến Nâng Cao
Dưới đây là một tệp cấu hình mẫu thực chiến minh họa cách đánh giá một Trợ lý Chăm sóc Khách hàng (Customer Support Bot) trên đồng thời 3 mô hình GPT-4o-mini, Claude 3.5 Haiku và Gemini 1.5 Flash:
Cơ chế biến (Variables) Bạn có thể định nghĩa hàng trăm test case khác nhau chỉ bằng việc thay đổi biến `vars.customer_query`. promptfoo sẽ tự động nạp các biến này vào template `{{customer_query}}` của prompt.
8. Tự Động Hóa Kiểm Thử CI/CD Trên GitHub Actions Chặn Lỗi Trước Production
Để ngăn chặn triệt để tình trạng mã nguồn hay prompt mới vô tình làm giảm chất lượng ứng dụng AI, hãy thiết lập workflow kiểm thử tự động với GitHub Actions tại `.github/workflows/ai-evals.yml`:
- **Tự động nhận diện thay đổi:** Chỉ chạy kiểm thử khi có thay đổi trong thư mục prompt hoặc cấu hình AI.
- **Bình luận bảng kết quả vào PR:** Toàn bộ thành viên trong nhóm có thể xem trực tiếp tỷ lệ pass, độ trễ và chi phí ngay trên giao diện GitHub PR.
- **Chặn merge khi phát hiện lỗi:** Tự động đánh dấu Pull Request là FAILED nếu có bất kỳ bài test quan trọng nào không vượt qua.
9. Câu Hỏi Thường Gặp (FAQ) & Chiến Lược Triển Khai Thực Tế
Tổng hợp các câu hỏi thực chiến thường gặp khi bắt đầu triển khai văn hóa kiểm thử LLM Evals trong doanh nghiệp:
- **promptfoo khác gì LangSmith hay Arize Phoenix?** LangSmith chuyên về giám sát ứng dụng đang chạy thực tế trên production (Runtime Tracing & Observability), còn promptfoo chuyên về kiểm thử tự động trước khi release (Pre-deployment Testing & CI/CD Gate). Chúng bổ trợ hoàn hảo cho nhau.
- **Tôi có thể kiểm thử hoàn toàn miễn phí không?** Hoàn toàn có thể. Bạn có thể cài đặt Ollama trên máy tính cá nhân để chạy các mô hình nguồn mở như Llama 3, Qwen hay DeepSeek-R1 và kết nối trực tiếp với promptfoo mà không tốn một đồng chi phí API.
- **Làm sao để kiểm soát chi phí token khi chạy nhiều test case?** Hãy kết hợp cơ chế Caching của promptfoo, sử dụng các assertion tĩnh (JSON, regex) cho các tiêu chí kỹ thuật và chỉ dùng LLM-as-a-judge cho các bài test mang tính định tính quan trọng.
Trong kỷ nguyên ứng dụng LLM, trực giác của lập trình viên không thể thay thế cho dữ liệu kiểm thử. Việc thiết lập bộ test case vững chắc với promptfoo ngay từ đầu là bảo hiểm tốt nhất cho chất lượng và uy tín sản phẩm của bạn.
Câu hỏi thường gặp
- promptfoo khác gì các nền tảng quan sát như LangSmith hay Arize Phoenix?
- LangSmith tập trung vào giám sát thời gian thực trên production (Runtime Tracing), còn promptfoo chuyên về kiểm thử tự động trước khi release (Pre-deployment Testing & CI/CD Evals).
- Dữ liệu prompt và API Key của tôi có bị gửi lên máy chủ ngoài không?
- Hoàn toàn không. promptfoo hoạt động theo triết lý Local-First, toàn bộ quá trình eval diễn ra ngay trên máy của bạn.
- Tôi có thể kiểm thử hoàn toàn miễn phí không?
- Có. Bạn có thể kết nối với Ollama để chạy các mô hình nguồn mở như Llama 3, Qwen hoặc DeepSeek mà không tốn một đồng phí API.
- Có hỗ trợ kiểm thử AI Agent có sử dụng Function Calling (Tools) không?
- Có. promptfoo hỗ trợ kiểm thử toàn diện khả năng chọn đúng tool và truyền đúng tham số của AI Agent.